文章目录
内容提要
显存账由三部分组成
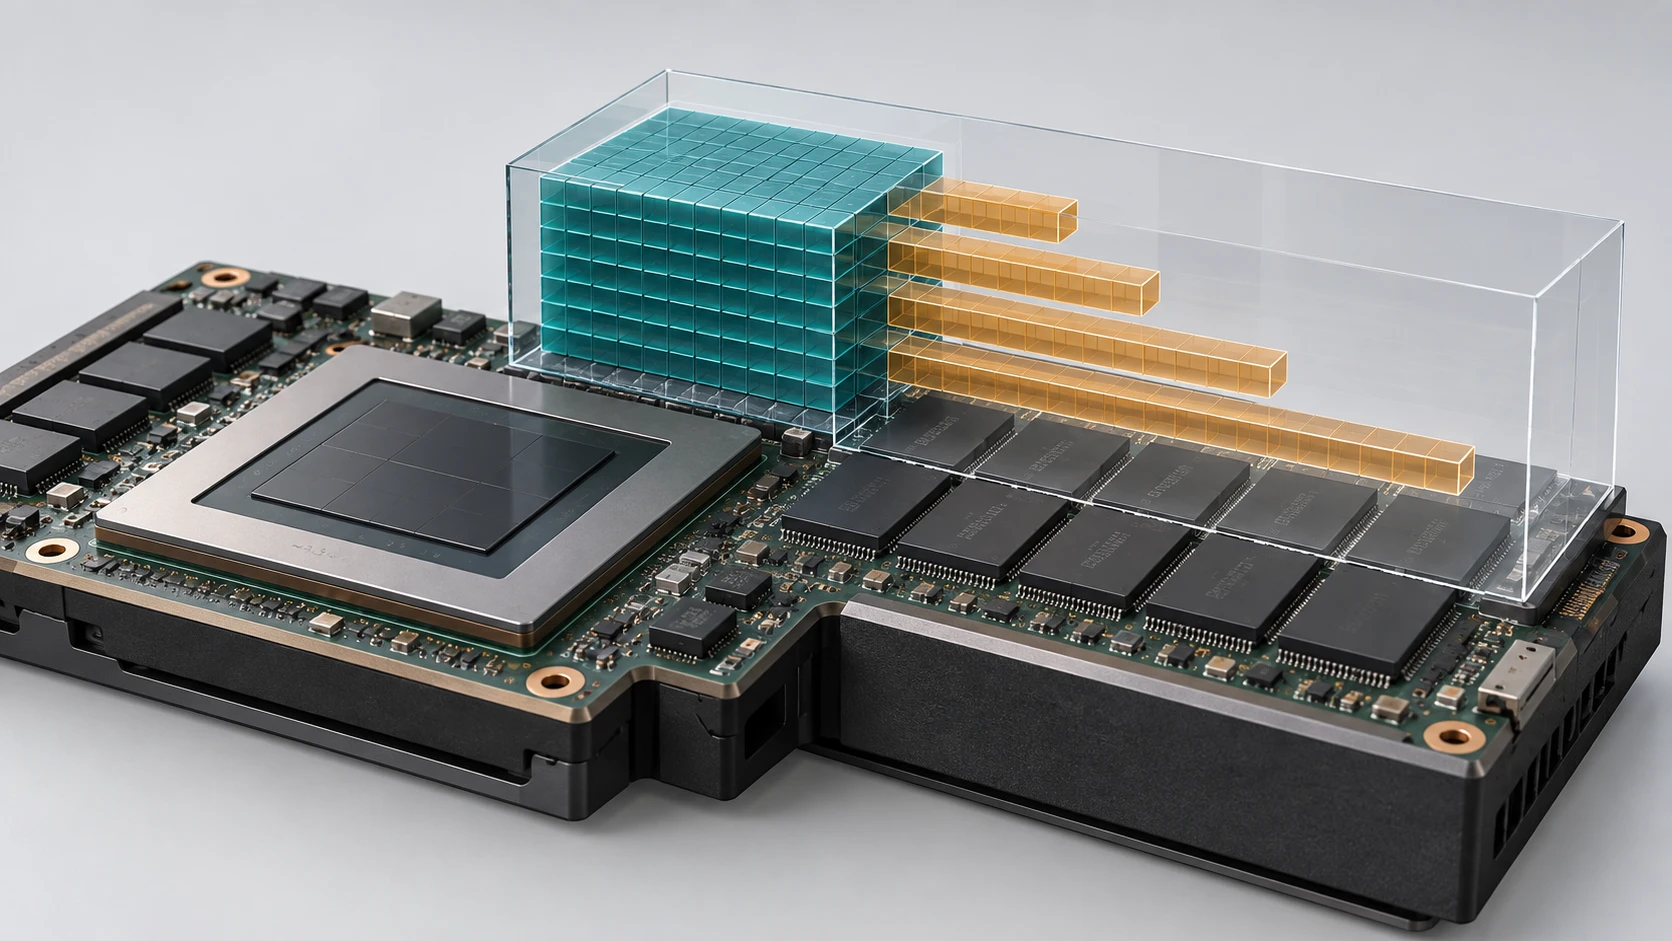
推理显存通常包含权重、KV cache、临时张量、框架预留与内存碎片。各部分随模型、精度、缓存策略、预填充与生成阶段而变化;不能用统一的一成或两成余量覆盖所有业务。应分别记录稳态与峰值,并验证目标并发下是否存在 OOM。
权重:参数量乘以每参数字节数
估算权重显存的通用逻辑是参数量乘以每参数字节数:FP16/BF16 约 2 字节,INT8 约 1 字节,INT4 约 0.5 字节。例如 7B 参数模型,FP16 权重约 14GB 量级,INT8 约 7GB 量级,INT4 约 3.5GB 量级。注意这是权重本身的量级估算,不含任何运行开销,不同框架的实际加载占用会有出入,以实测为准。
KV cache:上下文和并发的放大项
全注意力模型的动态 KV cache 通常随序列长度与并发增长,实际占用还与 KV 头数、层数和精度相关。滑动窗口、分块注意力、量化、卸载或前缀共享会改变增长方式。应核对实际模型与框架策略,不把上下文翻倍直接等同于所有模型的缓存翻倍。
为什么必须留余量
模型加载、预填充、并发峰值、内存碎片和环境变更都可能提高占用。先用目标配置压测代表请求,记录每卡峰值与稳定吞吐,再根据业务波动和扩展要求确定余量。不要以“单人留三成、低并发翻一倍”等固定比例作为采购结论。
三个演示算例
按十进制量级,仅计算 INT4 原始权重:7B 约 3.5GB,32B 约 16GB,70B 约 35GB。三者都未包含量化元数据、缓存和框架开销,也未限定上下文与并发。应把这些额外项加上后再比较具体单卡可用容量;需要多卡时还须确认切分支持和每卡占用,不能直接相加。
估完显存还没完:带宽与互联
显存容量决定放不放得下,显存带宽和卡间互联决定跑得快不快。生成式推理对显存带宽敏感,多卡拆分模型时卡间通信可能成为瓶颈。两张显存够用但互联偏弱的卡,未必好过一张高显存的卡。容量、带宽、互联要放在一起判断,这一步建议交给方案评估而不是只看参数表。
让估算落到配置
把模型参数量、量化精度、上下文长度、并发预期四个数写出来,就可以用页面上的 AI 配置顾问核一遍显存账,得到初筛方向。需要正式方案时提交项目需求,提交后由方案工程师继续确认配置、含税预算与交付范围。
选型检查清单
- 写清参数量、量化精度、上下文长度、并发四个变量
- 按参数量乘以每参数字节数估权重下限
- 并发服务为 KV cache 和峰值预留成倍余量
- 容量之外核对显存带宽与卡间互联
- 用目标框架小规模实测后再外推,不按纸面数拍板
适用范围与资料依据
权重裸容量不是完整运行显存;KV Cache 还取决于模型注意力结构、缓存类型、精度和部署策略。
资料链接核对:。具体版本支持以软件厂商最新文档为准。