PyTorch GPU 服务器配置方案
把推理、LoRA / 全量微调与多卡训练分开。先核算单任务显存、并行方式和数据供给,再确定 GPU 数量与平台形态。
先确认实际工作负载
同一模型在推理和训练时占用不同;权重之外,还有激活、梯度、优化器状态或推理 KV 缓存。多用户独占显卡与一个任务跨多卡也不同,不应只凭参数量或“需要几张卡”直接报价。
典型任务
- 模型训练
- LoRA / 微调
- 推理验证
- 数据预处理
- 多用户远程实验
需要识别的瓶颈
- 显存不足
- 数据读取跟不上 GPU
- CUDA / 驱动版本混乱
- 长时间满载散热和供电压力
硬件投入重点
- GPU
- 按模型、精度、批量和序列长度测峰值。常规 DDP 为各进程保留模型副本,不会自动把多卡显存合并;分片需另选 FSDP 等策略。
- 数据盘
- 区分原始数据、预处理缓存与检查点;结合样本大小、随机读取和网络存储测试,不只比较顺序读写峰值。
- CPU/内存
- 检查 DataLoader、解码、增强和工作进程占用,预留检查点与多实验资源;GPU 等数据时先查供给链路。
- 环境
- 锁定 PyTorch 构建、驱动和依赖版本;容器内运行时与宿主驱动分别核对,自定义算子还需匹配编译工具链。
按任务选择平台
以下是讨论方案的起点,不是固定套餐。验证项目和交付范围需双方确认,未测试前不承诺性能。
开发与推理
验证模型、推理或可容纳的微调实验。
平台方向先满足单任务显存与环境依赖,再测目标批量、上下文和并发;不能仅凭参数量推断配置。
验证重点任务完整跑通、显存峰值、目标并发下延迟与输出质量。
多人实验
不同用户运行相互独立的实验。
平台方向按同时运行任务配置 GPU、CPU、内存和配额,规划用户隔离与数据权限,不必默认高速跨卡训练拓扑。
验证重点多任务同时读数据、保存检查点与资源隔离。
单任务多卡
单个训练任务需要跨卡并行或分片。
平台方向明确 DDP / FSDP / 模型并行策略后核对拓扑、互联、网络与内存,按扩展收益和机房条件定平台。
验证重点相同训练目标的端到端吞吐、通信时间与恢复行为。
软件依据与版本核对
软件支持随版本变化。以下为厂商资料,不代表英睿特的认证、合作关系或具体交付承诺。
- PyTorch DistributedDataParallel 入门
说明模型副本、梯度同步及与模型并行的区别,不将多卡显存视作自动共享。
与此方案关联的产品
候选平台不是固定配置;部件、容量和部署边界需按项目确认。
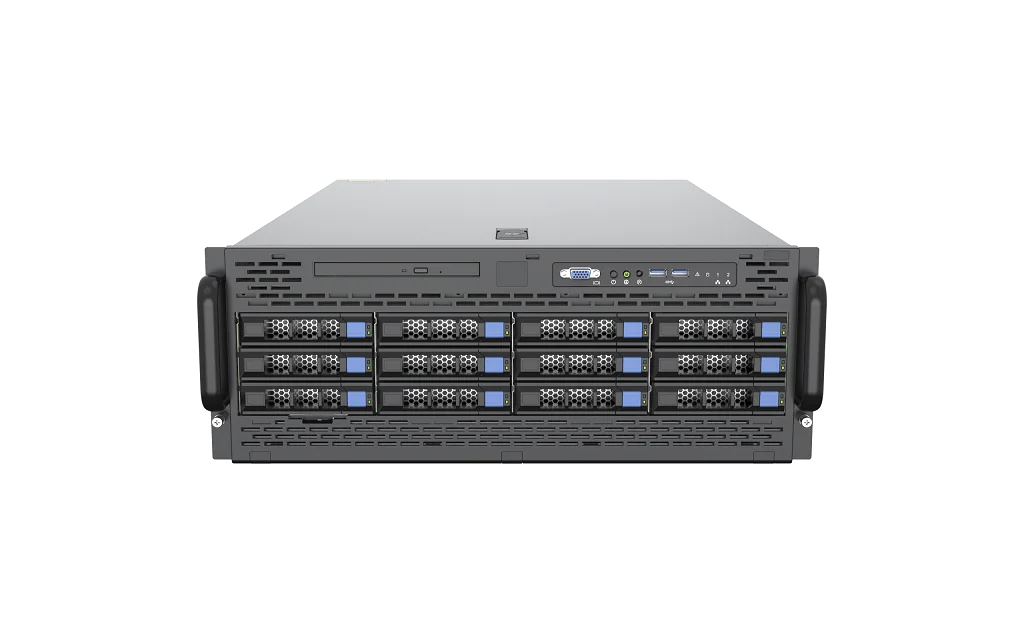
T4 V8 AI 训练服务器
AI 训练入门主力,强调 CUDA、驱动、容器环境、数据吞吐和满载验证;适合实验室与企业 AI 研发起步。
- CPU
- Intel Xeon 6 P-core
- GPU
- 4x RTX PRO 6000 / L40S / 同级训练 GPU
- 内存
- 512GB - 1TB ECC
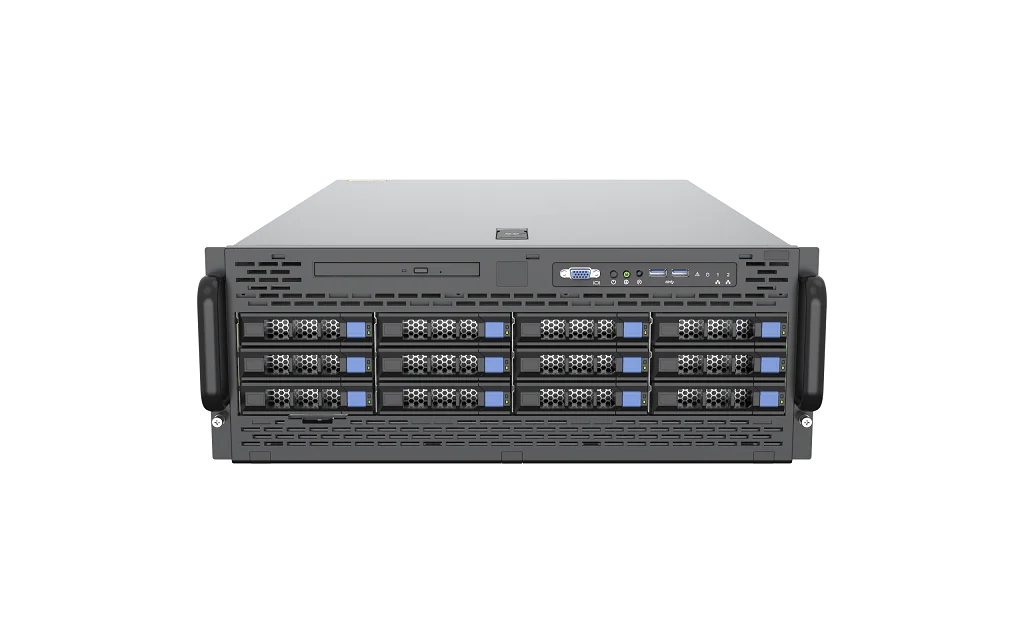
G4 V8 GPU 计算服务器
GPU 计算主力产品,适合 AI 推理、GPU 渲染、CAE 加速和多用户计算;优先采用成熟 4 GPU 风道和冗余供电底座。
- CPU
- Intel Xeon 6 P-core
- GPU
- 4x NVIDIA L40S / RTX PRO 6000 / RTX 6000 Ada 级 GPU
- 内存
- 512GB - 1TB ECC
报价前需要确认什么
需求清单
- 模型与 PyTorch 版本、训练 / 微调 / 推理类型
- 精度、批量、序列长度、优化器或 KV 缓存目标
- DDP / FSDP 等并行策略与单任务显存记录
- 数据类型、容量、加载方式与检查点大小
- 独立用户并发或单任务跨卡、供电散热和网络
配置依据与准备资料
常见问题
PyTorch 服务器是不是 GPU 越多越好?
不是。还要看模型并行方式、显存容量、数据读取、CPU 喂数、网络和散热供电。
为什么要提前规划 CUDA 和驱动?
框架预编译包、宿主驱动与自定义算子工具链是不同层次。应锁定团队模型实际需要的版本组合,并在目标环境验证,而不是简单把所有组件升到最新。
把实际任务交给我们一起确认
软件版本、项目规模、预算和部署条件,是配置沟通的起点。