文章目录
内容提要
先分清利用率与有效吞吐
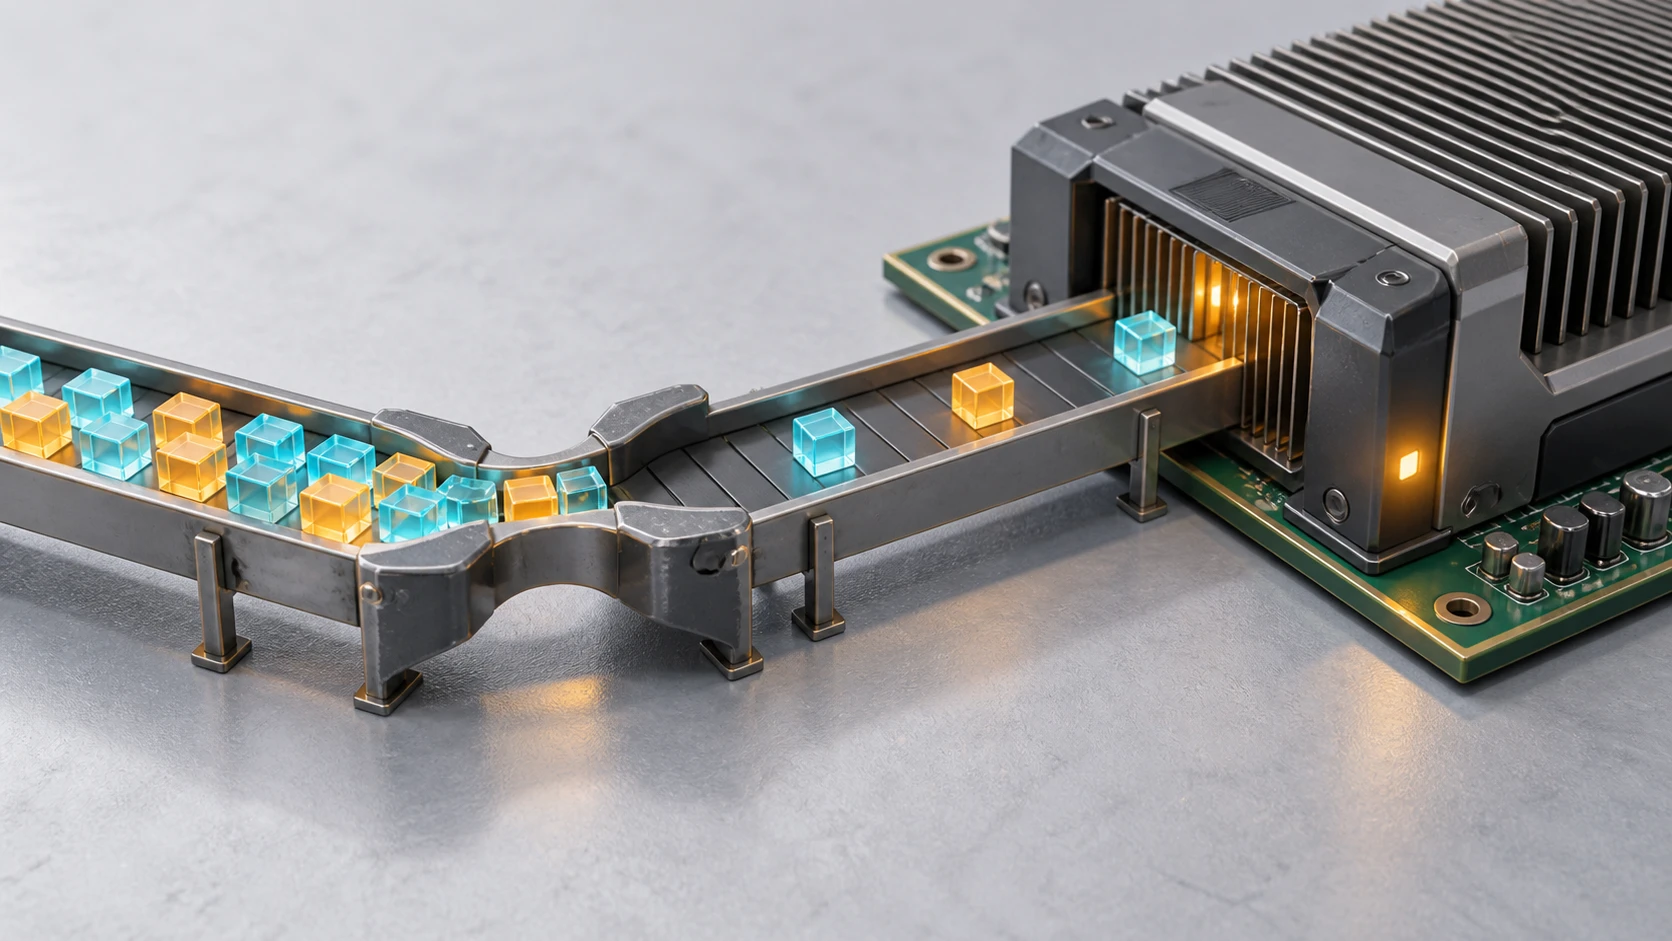
nvidia-smi 的 GPU 利用率表示采样期间至少一个计算内核正在执行的时间比例,不等于算力使用了多少,也不能直接换算成训练效率。30% 或 100% 都不足以单独判断瓶颈。应同时记录每步耗时、样本吞吐、数据等待、通信、显存和功耗,再决定是否需要升级。
先按这条链路排查
建议按"利用率曲线形态 → dataloader 与数据增强 → 本地 NVMe 对比 → 单卡/多卡单步耗时 → profiler 证据 → 硬件升级方向"这个顺序走。这个顺序的好处是先排除低成本问题,再判断是否需要采购。若一上来只看 GPU 型号和卡数,很容易把软件、数据和存储问题误判成硬件不足。
第一嫌疑:数据加载管道
数据加载进程、解码与增强、预取和样本读取都可能成为瓶颈。利用率曲线出现锯齿只能提示值得排查,不能据此确诊喂数不足。用 profiler 区分加载、计算、同步和检查点阶段,逐项调整并比较同一任务的端到端耗时。
第二嫌疑:存储吞吐
数据集在机械盘、网络共享盘或过载的 NAS 上时,随机小文件读取会把加载管道饿死。判断方法:把一个子集复制到本地 NVMe 再跑一轮对比。差异明显就先解决数据集的存放位置——本地 NVMe 缓存盘或专门的数据集存储,这比换卡便宜得多。
第三嫌疑:卡间通信与并行策略
多卡训练里,梯度同步的时间不产出算力。batch 偏小、同步频繁、卡间走普通 PCIe 而通信量又大、并行策略与模型不匹配,都会让通信吃掉利用率。判断方法:对比单卡与多卡的单步耗时,多卡不升反降或提升远低于卡数比例,通信环节就值得细看。
用工具看,不要猜
训练框架自带的 profiler 能直接给出每步时间花在计算、数据等待还是通信同步上;系统层面观察 CPU 占用、磁盘队列和网络吞吐可以交叉验证。花半天跑一次 profile,比按猜测升级硬件更可靠。排查结论建议留档,下一次采购时可以直接作为配置边界和验收口径。
什么时候真该动硬件
三种情况硬件确实是瓶颈:显存不足被迫用小 batch 或频繁重算,加载与通信都不是主因;profile 显示计算本身占满而训练时长仍不达标;多机扩展需求出现,网络与互联必须升级。这时的升级方向按瓶颈对号入座——显存不足看高显存卡,通信受限看互联与拓扑,吞吐不足才是加卡换卡,具体配比需按项目确认。
下一步
把六样东西写清楚:卡数与型号档位、数据集位置与规模、batch 与并行方式、单卡/多卡单步耗时、利用率曲线特征、profile 结论(若有)。可以用页面上的 AI 配置顾问按这些条件先判断瓶颈方向;需要正式方案时提交项目需求,提交后由方案工程师继续确认配置、含税预算与交付范围。
选型检查清单
- 按曲线形态、数据加载、本地 NVMe 对比、单卡/多卡步时、profiler 顺序排查
- 数据集复制到本地 NVMe 对比一轮,排除存储瓶颈
- 对比单卡/多卡单步耗时,判断通信占比
- 用框架 profiler 拿证据,把结论留作采购和验收依据
- 确认是显存、通信还是算力瓶颈后,再对号升级硬件
适用范围与资料依据
GPU utilization 表示采样周期内运行内核的时间比例,不直接代表计算单元满载或任务吞吐。
资料链接核对:。具体版本支持以软件厂商最新文档为准。