文章目录
内容提要
先用模型规模反推显存,而不是先数 GPU
GPU 数量只是起点。模型参数量、batch size、精度策略、上下文长度、优化器状态和并发任务,会共同决定显存是否足够。显存不足时,任务可能需要降低 batch、缩短上下文、启用更激进的量化或切分策略,实验效率和可复现性都会受影响。
GPU 互联和 PCIe 拓扑会影响多卡效率
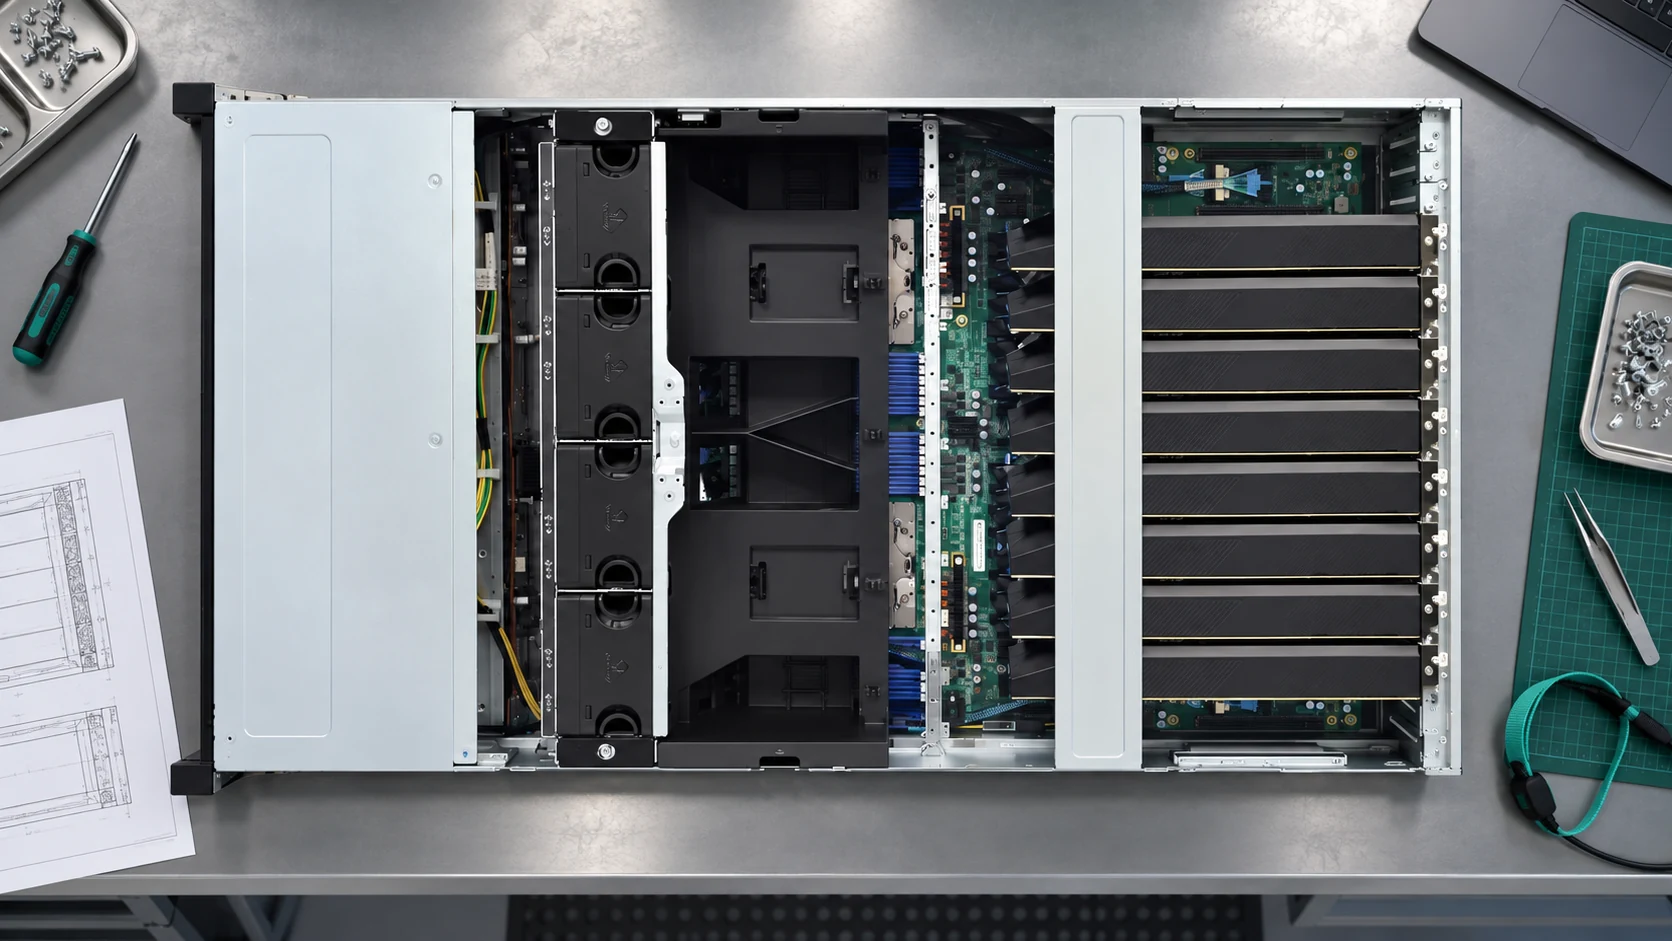
多卡训练并不等于性能线性增加。GPU 之间的通信方式、PCIe 通道、NUMA 拓扑、CPU 插槽、框架并行策略和任务类型都会影响扩展效率。对于大模型训练、分布式训练或多用户并发,互联和拓扑要和 GPU 型号一起评估。
CPU、内存和 NVMe 决定能否把数据送到 GPU
训练数据集读取、解码、预处理、增强、缓存和日志写入,都会消耗 CPU、内存和存储 IO。NVMe 数据缓存、足够内存、合理 CPU 核心数和网络带宽,可以减少 GPU 等待数据的时间。只堆 GPU,常常会让瓶颈转移到数据路径。
网络和存储要按单机、多机分别规划
单机多 GPU 更关注本地 NVMe、PCIe 拓扑和散热;多节点训练还需要关注高速网络、RDMA、交换机、共享存储和节点间通信。若未来可能扩展到多节点,应在首台服务器选型时保留网络和机柜余量。
长期满载能力是训练服务器的基本要求
4-8 GPU 服务器在训练和微调时可能连续数小时或数天满载运行。供电、散热、风道、冗余电源、远程管理和机柜环境都需要提前确认。机房条件不足时,高规格 GPU 也可能因温度、功耗或噪声无法稳定运行。
交付验收要包含软件环境和压力测试
AI 服务器验收不应只确认硬件到货。建议记录 GPU 识别、显存容量、驱动和 CUDA 或框架版本、GPU 满载温度、功耗状态、远程管理信息和样例训练任务。这样后续复现实验、排查故障和扩容都有依据。
选型检查清单
- 根据模型规模、精度、batch 和并发任务估算显存
- 确认 GPU 互联、PCIe 拓扑和多卡扩展效率
- 规划 CPU 喂数、内存、NVMe 缓存和数据集读取路径
- 确认单机还是多节点、是否需要高速网络和共享存储
- 把机房供电、散热、远程管理和满载验收写进方案
适用范围与资料依据
先确定框架与计算平台版本,再核对 CUDA 和驱动兼容条件。兼容性说明不能替代显存测算、整机验证或训练性能测试。
资料链接核对:。具体版本支持以软件厂商最新文档为准。