文章目录
内容提要
GPU 利用率受整条数据路径影响
训练数据从共享存储、网络、本地缓存、CPU 预处理到 GPU 的路径中,任何一段过慢都会让 GPU 等待。只看 GPU 型号和数量,无法保证实际训练效率。多卡平台尤其要关注数据加载、批处理、预处理线程和文件系统性能。
NVMe 缓存适合热数据、样本缓存和中间结果
本地 NVMe 可以承载高频训练数据、临时缓存、预处理结果、Checkpoint 和实验日志,减少反复从容量层读取。容量层和归档层则负责长期数据保存、共享和备份。热数据、容量数据和归档数据应分层设计。
RDMA 和高速网络要按训练规模决定
单机多 GPU、双节点训练和多节点训练对网络要求不同。只有当任务确实需要跨节点通信、参数同步或高速共享数据时,RDMA、高速网卡和交换网络才是关键投入。否则预算可能更适合放在单机 GPU、内存和本地 NVMe 上。
共享存储要同时考虑吞吐、容量和权限
AI 数据集、模型权重、实验结果和日志通常需要多人共享。共享存储不仅要看总容量,还要看并发读取、快照、备份、权限、恢复目标和网络链路。若存储只按容量采购,后期很容易成为训练效率和数据管理的瓶颈。
多节点训练要提前画清拓扑
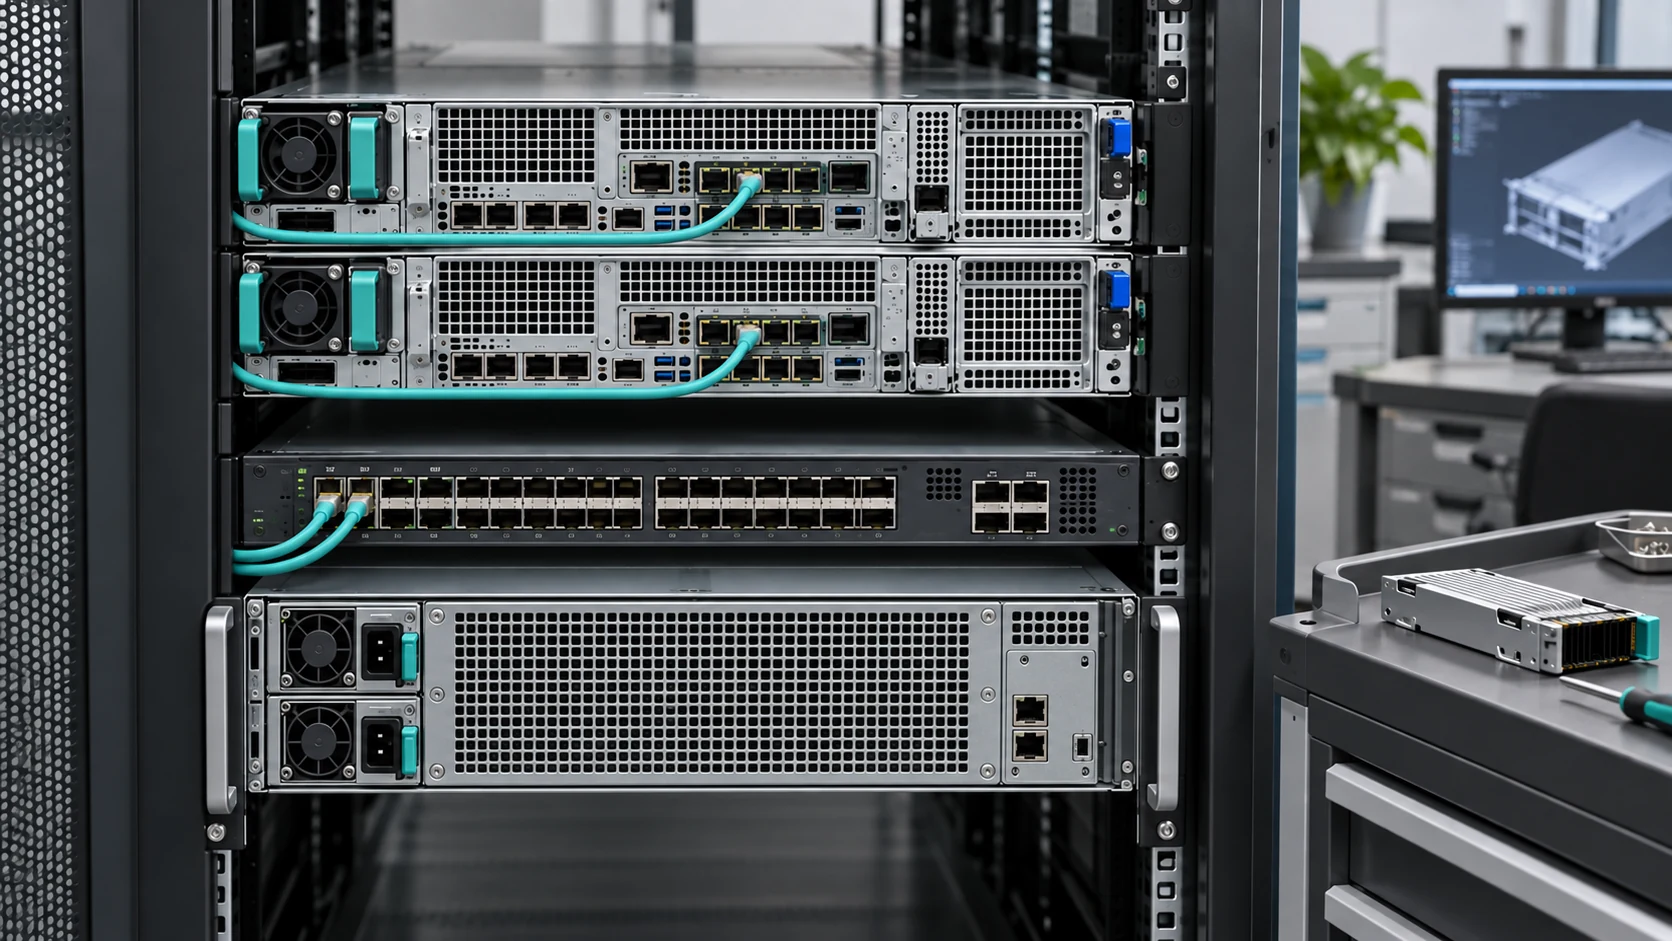
节点数量、GPU 数量、PCIe 拓扑、NVLink 或同类互联、网卡位置、交换机带宽和存储路径,都会影响性能。方案阶段应把训练框架、数据集位置、缓存策略、节点数量和网络拓扑放在同一张图里评估。
上线后要观测 GPU、IO 和网络三类指标
多卡平台是否有效,不能只看 GPU 是否亮起。建议同时观察 GPU 利用率、显存占用、数据加载耗时、磁盘 IO、网络吞吐、Checkpoint 写入和任务失败率。只有这些指标闭环,才能判断瓶颈到底在算力、存储还是网络。
选型检查清单
- 确认数据集大小、文件数量、读取方式和预处理流程
- 区分单机多 GPU、双节点或多节点训练
- 规划本地 NVMe、共享存储、快照备份和权限
- 确认 RDMA、高速网卡和交换网络是否真的需要
- 上线后同时观测 GPU 利用率、磁盘 IO 和网络吞吐