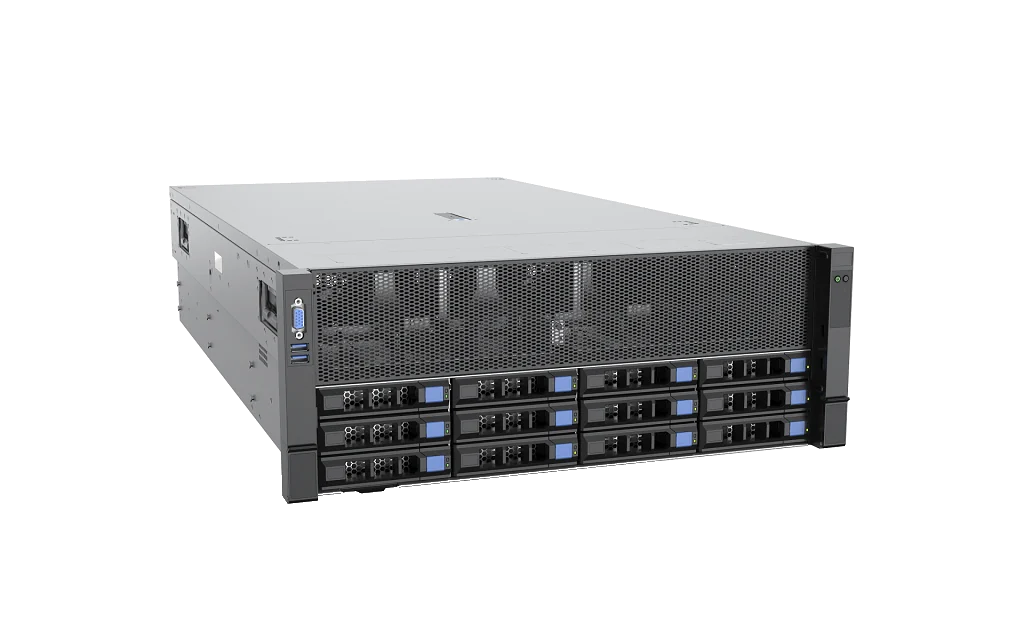
沿用目录平台参考图,不作为具体部件、接口和盘位的交付依据;实际配置以项目确认表为准。
英睿特 T 系列
T8A V8 AI 训练服务器
大模型微调 / 科研训练 / 企业模型平台
- 系统形态
- 4U / 6U / 8U 8 GPU AI 训练服务器,按 GPU 功耗、互联方式和机柜条件确认
- CPU 平台
- AMD EPYC 9005 双路
- GPU / 加速
- 8x 高显存训练 GPU,H200 / B200 / L40S 等按项目确认
- 内存范围
- 1TB - 2TB ECC
- 存储方向
- NVMe 数据池 + 200/400GbE / InfiniBand
部件选项、内存与存储需组合确认,不等同于固定标配。
适用负载与部署边界
适用方向
高客单训练平台,GPU、网络、存储、调度、环境镜像和交付验证都需要配置确认。
- 企业或科研团队的高端训练节点
- 需要 8 GPU、高速网络和训练数据池
- 准备建设多用户模型训练平台
- 大模型微调
- 科研训练
- 企业模型平台
- 多机训练
需要另行评估
- 只做推理或 GPU 渲染
- 没有高速存储和网络的数据密集训练
- 供电制冷条件无法支持高功率 GPU 长时间满载
如果项目已经需要 HGX/NVSwitch 或整柜规划,应进入 T8X V8 / T-RackScale V8 项目;如果只是 4 GPU 实验,T4 V8 更合适。
重新判断平台方向采购前确认
- 模型规模和多 GPU 通信效率
- 200/400GbE 或 InfiniBand 规划
- 训练数据池和 checkpoint 策略
- 调度、监控和多用户权限
关键规格与配置选项
公开目录选项不等同于已认证的任意组合。
| 项目 | 配置内容 | 信息性质 |
|---|---|---|
| CPU 平台 | EPYC 9005 双路 | 目录选项 |
| GPU / 加速选项 | 8x H200 项目确认 / 8x B200 项目确认 / 同级训练 GPU | 目录选项 |
| 内存选项 | 1TB ECC / 2TB ECC | 目录选项 |
| 存储与网络方向 | NVMe 数据池 / 200/400GbE / InfiniBand | 目录选项 |
| 固定标配 | 当前平台目录未定义固定标配,以报价清单为准。 | 项目确认 |
| 最大支持能力 | 最大容量、数量与功耗需按具体部件、拓扑和散热条件确认。 | 项目确认 |
| 尺寸、盘位与电源 | 具体尺寸、物理盘位、电源型号与额定功率需在项目确认表中锁定。 | 项目确认 |
配置沟通档位
用于讨论配置方向,不代表固定库存型号或最终报价。
确认档
8 GPU 高显存训练平台,1TB ECC,NVMe 数据池,200GbE,基础训练环境
进阶档
8 GPU 高显存训练平台,2TB ECC,200/400GbE 或 IB,NCCL 与训练样例验证
扩展档
H200 / B200 等高端训练 GPU、多机训练、调度、存储、网络和液冷/风冷方案
完整平台资料
平台规格与工程指导分开理解,最终以项目确认表为准。
7 组平台资料
处理器与平台
- CPU 选项
- AMD EPYC 9005 双路
- 平台体系
- AMD 平台
- 可选平台
- EPYC 9005 双路
- 平台定位
- 8 GPU 训练平台,面向大模型微调、科研训练和企业模型平台;按 4U/6U/8U 机箱平台、GPU 功耗和互联方式确认
- 平台主板
- AMD EPYC AI 训练服务器平台,按 GPU 互联、PCIe 通道、网络和存储路径规划
- 芯片组/通道
- 训练服务器平台,重点确认 GPU 互联、PCIe/NVLink、网络和散热方案
- 系统环境
- Linux 为主,PyTorch / TensorFlow / CUDA / Slurm / Kubernetes 可选
内存与扩展
- 内存范围
- 1TB - 2TB ECC
- 可选内存
- 1TB ECC / 2TB ECC
- 内存拓扑
- ECC 大内存,容量按模型规模、数据预处理和多用户训练规划
- 容量建议
- 建议 1TB 起步,高显存训练、多用户实验和大数据管线建议 2TB ECC
- PCIe 扩展
- 8 GPU PCIe 或高密度训练拓扑,重点确认 PCIe Switch、GPU 互联、网络卡位置和散热边界
GPU 与加速
- GPU 方向
- 8x 高显存训练 GPU,H200 / B200 / L40S 等按项目确认
- 可选 GPU
- 8x H200 项目确认 / 8x B200 项目确认 / 同级训练 GPU
- 拓扑/数量
- 8 GPU 高显存训练方向,重点确认 GPU 供应、互联方式、通信效率、NCCL 表现和训练框架适配
- 供电关注
- 训练 GPU 满载时间长,需同步核算机柜供电、散热、线缆和冗余策略
- 适配软件
- PyTorch / TensorFlow / CUDA / Slurm / Kubernetes
存储与数据
- 存储策略
- NVMe 数据池 + 200/400GbE / InfiniBand
- 可选存储
- NVMe 数据池 / 200/400GbE / InfiniBand
- 盘位/缓存
- NVMe 数据池 + 200/400GbE 或 InfiniBand,避免训练数据瓶颈
- 数据分层
- 建议训练热数据落在本地 NVMe 或高速共享存储,冷数据进入容量层
- 保护策略
- 按实验数据、模型 checkpoint、日志和数据集版本规划备份策略
网络与管理
- 网络选项
- 200/400GbE 或 InfiniBand 方向,按多机训练和存储吞吐规划
- 远程管理
- 带外管理、CUDA/NCCL/容器/调度环境交付
- 安全策略
- 支持多用户实验环境、容器镜像、数据权限和内网训练平台策略
- 部署运维
- 可提供 CUDA/NCCL/驱动版本、容器镜像建议、训练环境交付说明和测试记录
机箱电源散热
- 机箱形态
- 4U / 6U / 8U 8 GPU AI 训练服务器,按 GPU 功耗、互联方式和机柜条件确认
- 电源策略
- 8 GPU 训练平台需按整机满载、机柜供电、PDU 和制冷条件核算
- 散热验证
- 高密度训练需验证 GPU 温度曲线、NCCL 通信和长时间训练稳定性
- 部署环境
- 训练平台建议机房部署;高密度 GPU 需提前确认供电、制冷和承重
- 交付边界
- 8 GPU AI 训练服务器
交付与支持
- 交付周期
- 按 GPU 供应与项目条件确认
- 满载验证
- 建议验证 NCCL、多 GPU 训练样例、数据加载、网络吞吐、checkpoint 和温度
- 交付资料
- 可提供 CUDA/NCCL/驱动版本、容器镜像建议、训练环境交付说明和测试记录
- 项目说明
- 具体品牌、料号、尺寸、盘位和电源型号以最终报价单与项目确认表为准
软件与工作流
交付前一起确认
训练平台条件
确认高功率 GPU 供电、制冷、网络互联、数据路径和调度环境。
数据路径
确认本地盘、项目盘、共享存储、备份和数据不落地要求。
交付验证
交付前建议记录驱动版本、系统环境、满载测试和基础软件验证结果。
按 GPU 供应与项目条件确认。具体交付范围、周期及服务条款以项目确认与合同为准。
同系列其他平台
查看本系列

从您的工作负载开始
软件、数据规模、预算与部署条件,都是配置沟通的起点。